
在手机上运行 AI 大语言模型,离线私密对话。
可以把它理解为移动端的 Ollama。🐕
Shiba 不会让你变成 AI 研究员……但可能会让你觉得自己是。
无需云端,无需 API Key,数据不离开设备。只有你和本地大模型的对话。
简体中文 · English




Ollama 让在 PC 上运行大模型变得无比简单。Shiba 把同样的体验带到了手机上。
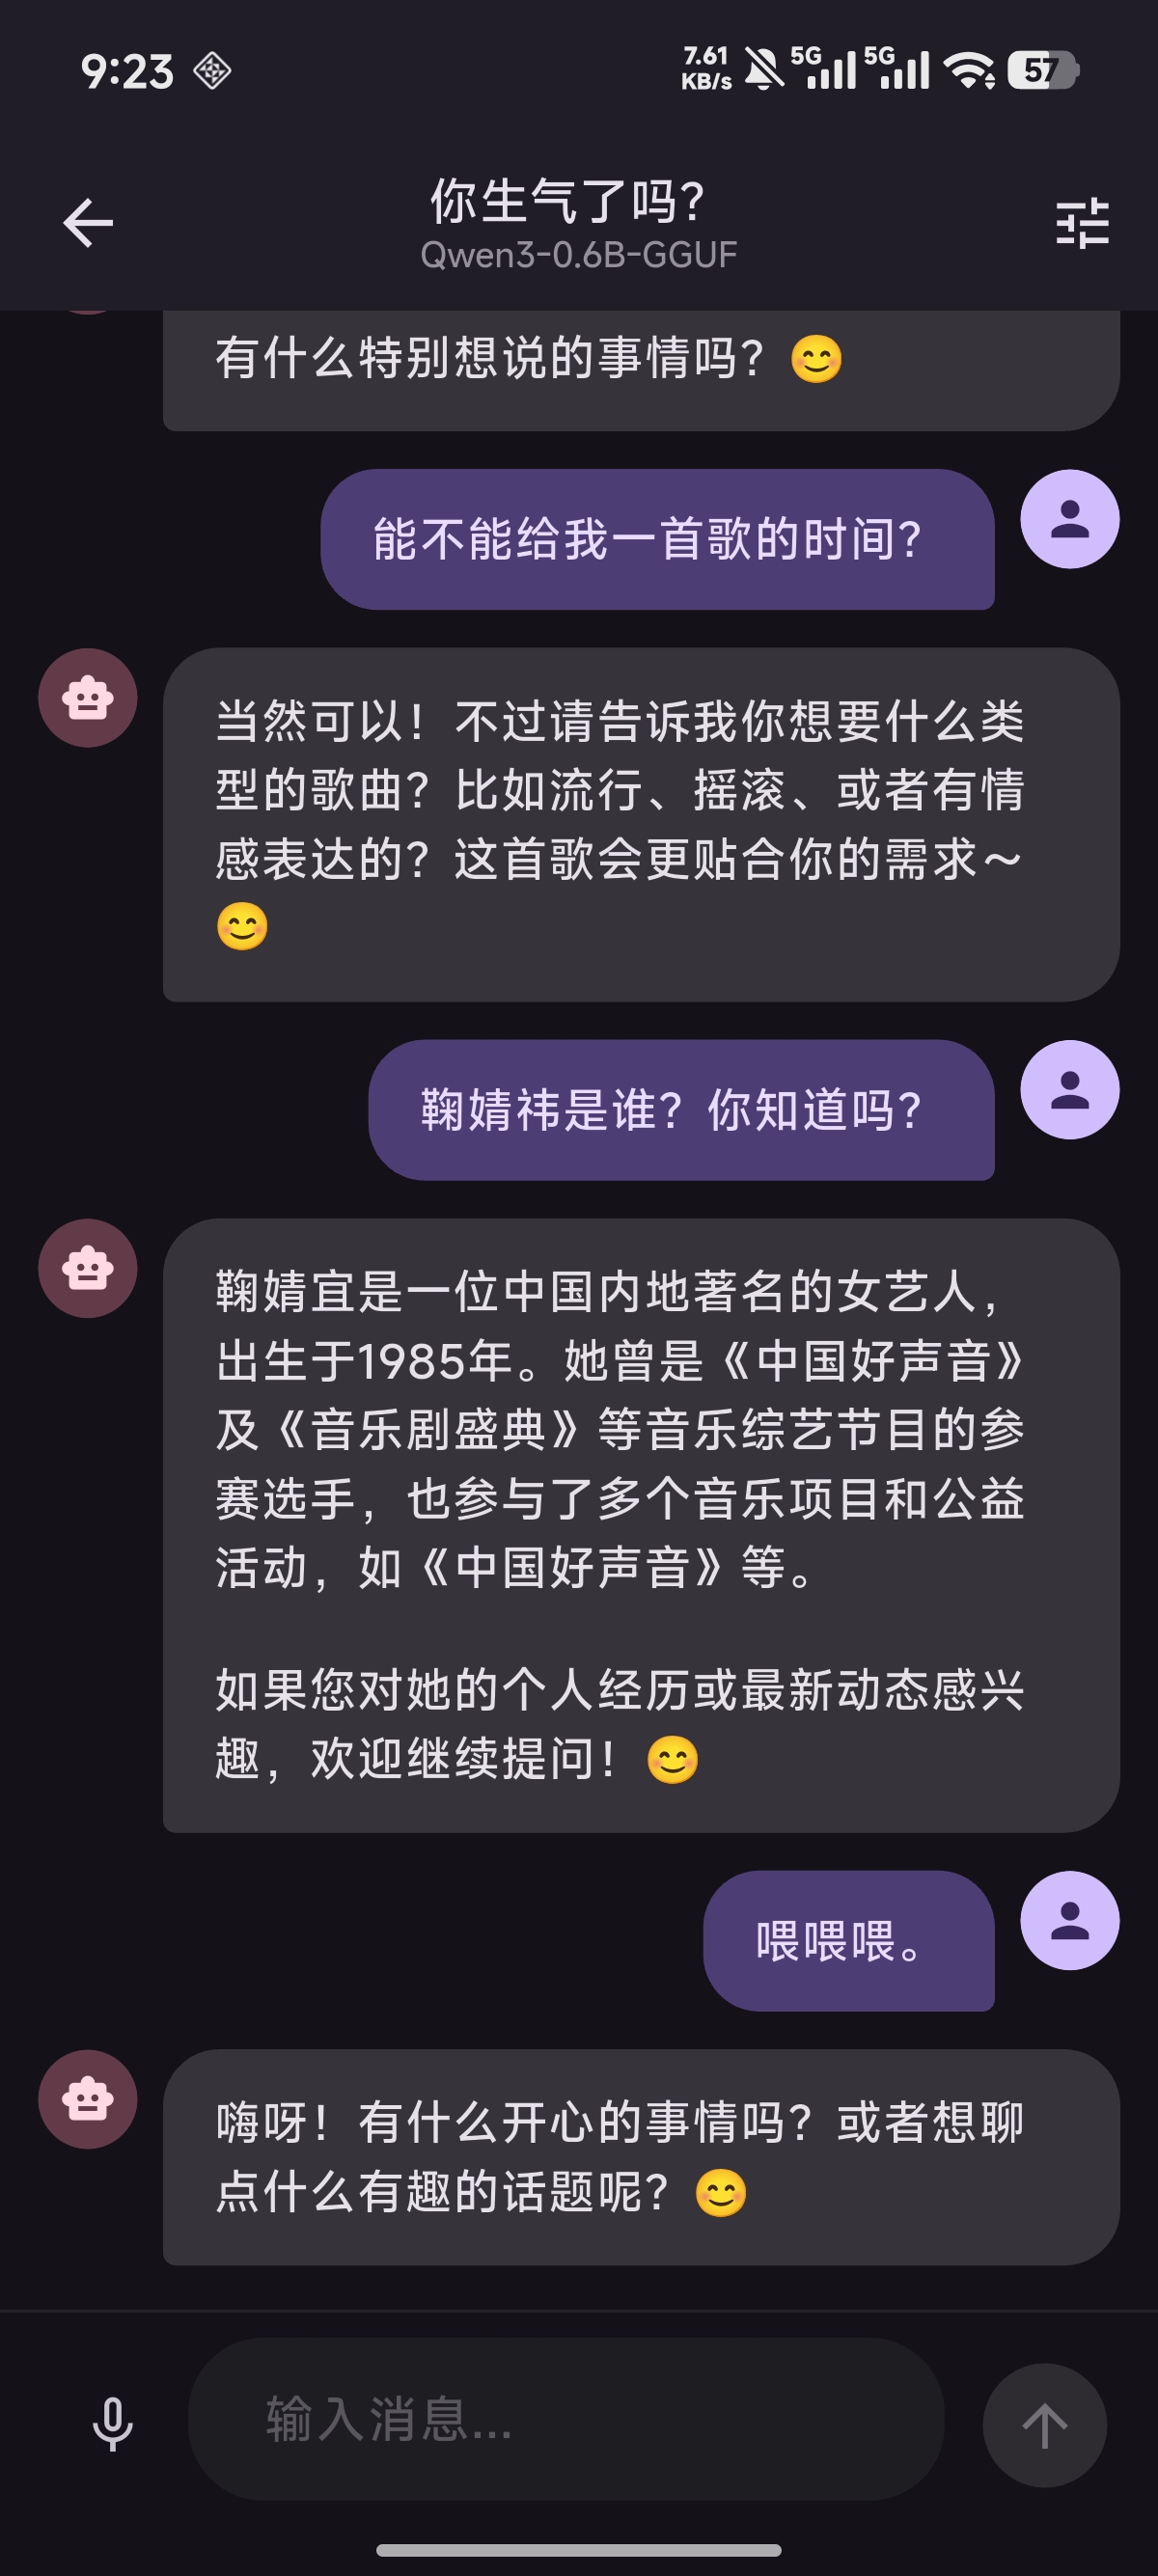
不需要搭建服务器,不需要记命令行。从 Hugging Face 下载模型,点击开始,就能对话——全部在设备上完成,全程离线,完全私密。如果说 Ollama 是桌面端的大模型利器,那 Shiba 就是你口袋里的 AI 伙伴。
| 特性 | 说明 |
|---|---|
| 🤖 本地大模型推理 | 通过 llama.cpp 直接在设备上运行 GGUF 模型,支持多阶段回退策略(GPU → CPU → 最小上下文),最大化兼容性 |
| 🔒 完全离线与隐私 | 所有推理在本地完成,无需云端、无需 API Key,数据永远不会离开你的手机 |
| 👁️ 多模态图片理解 | 向视觉模型(LLaVA、MiniCPM-V 等)发送图片,自动检测并加载 mmproj 视觉投影器 |
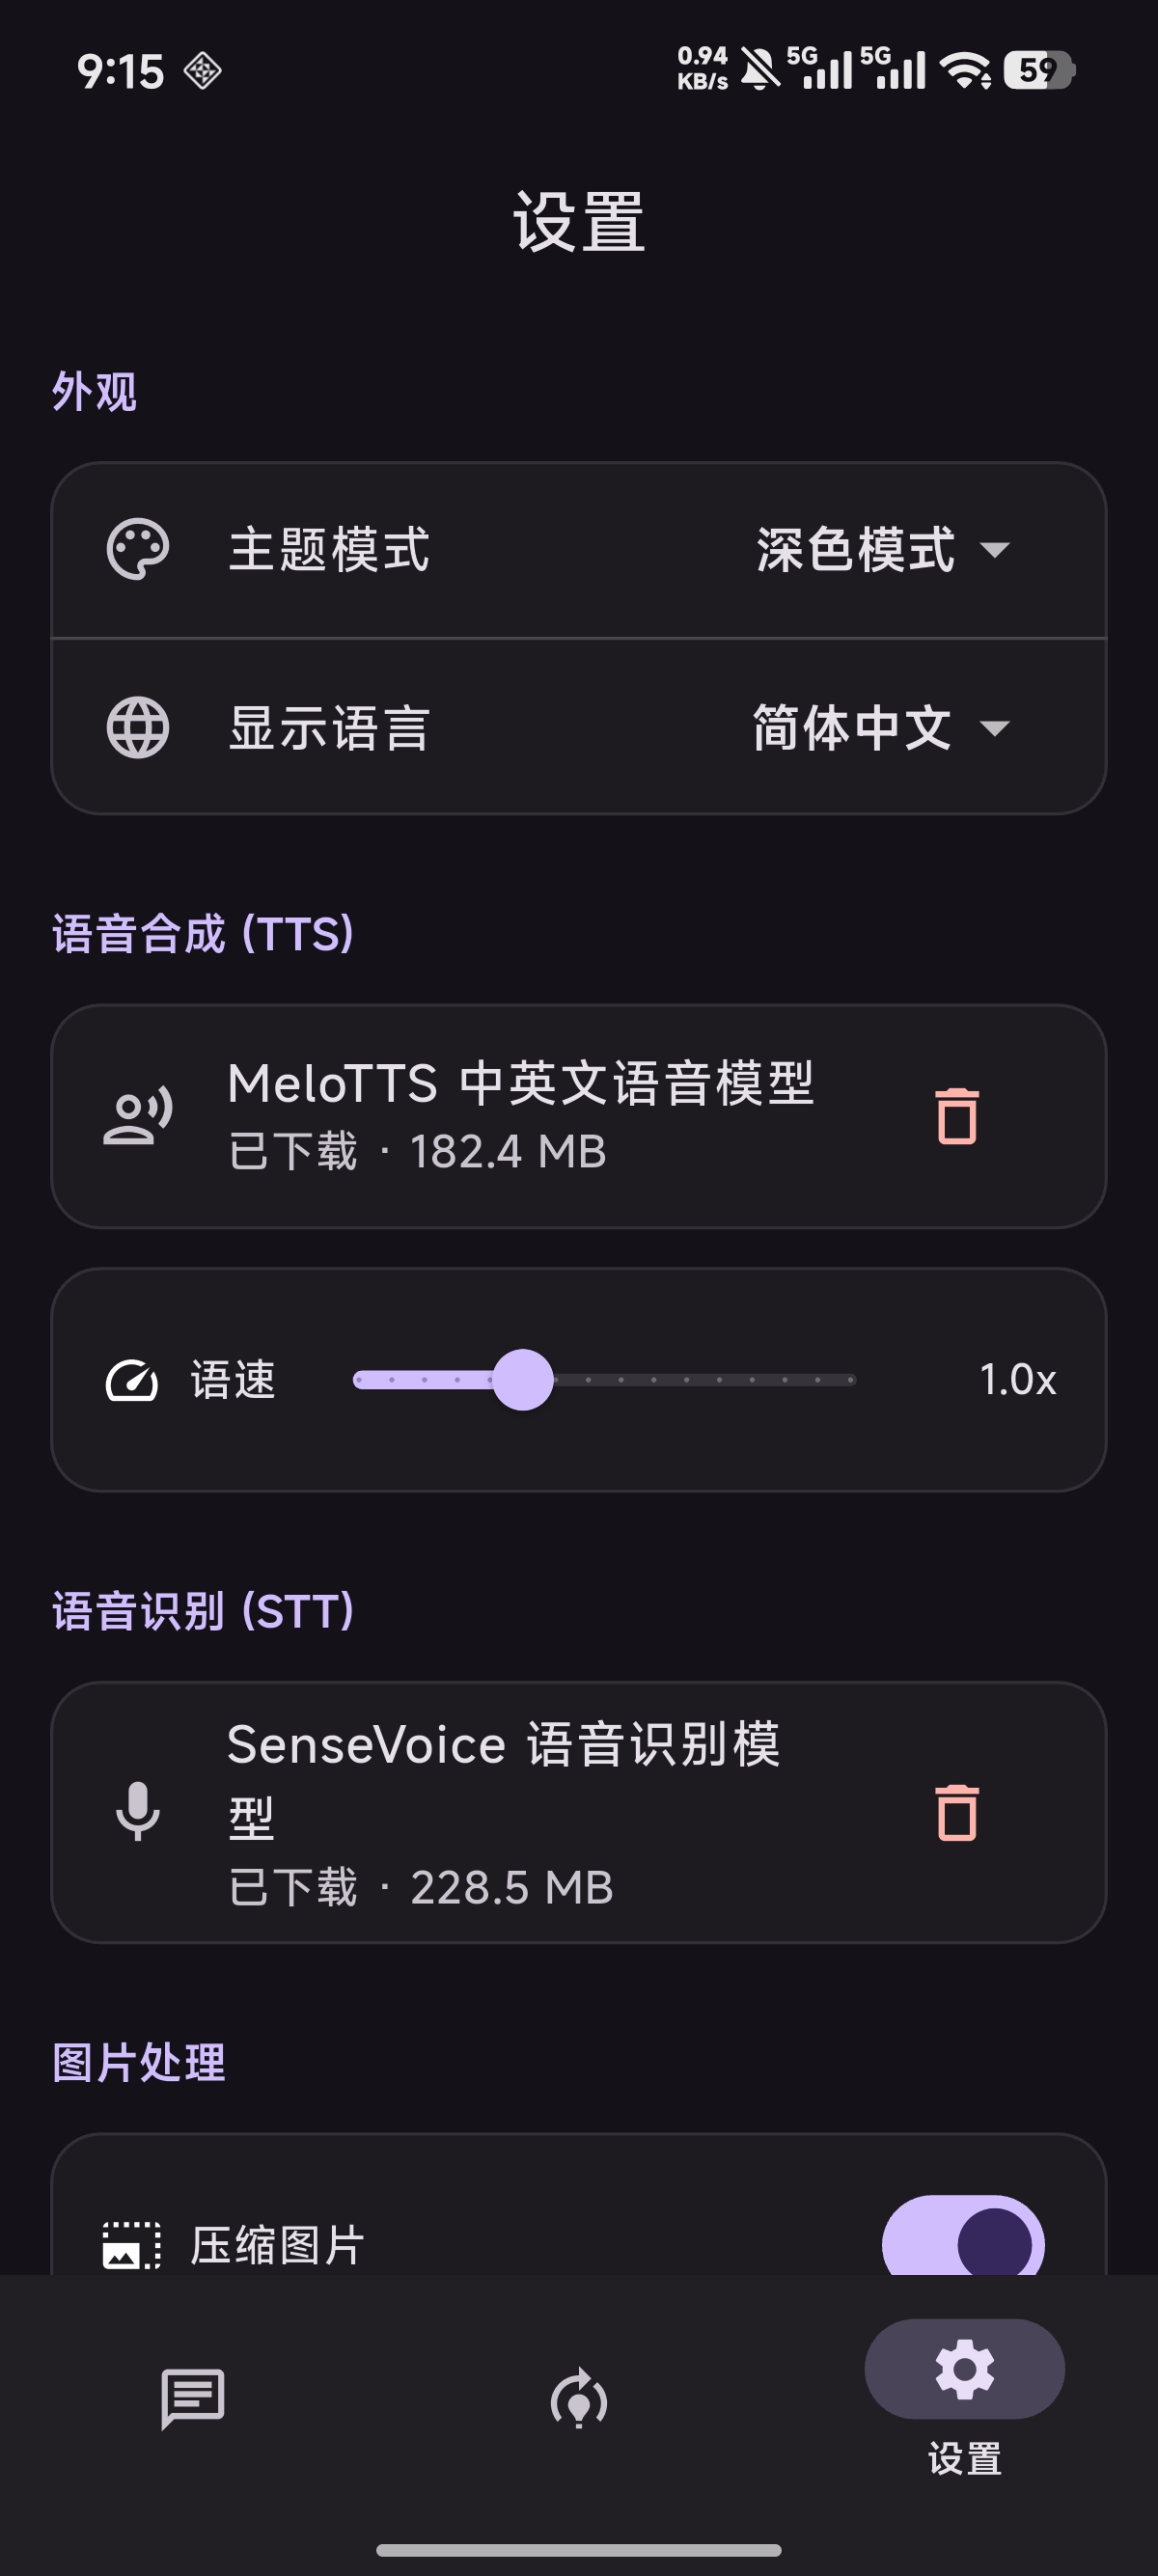
| 🗣️ 文字转语音(TTS) | 内置离线 TTS 引擎,基于 sherpa-onnx MeloTTS,可朗读 AI 回复,支持调节语速 |
| 🎙️ 语音转文字(STT) | 离线语音输入,基于 SenseVoice 模型,支持中文、英文、日语、韩语、粤语,解放双手与模型对话 |
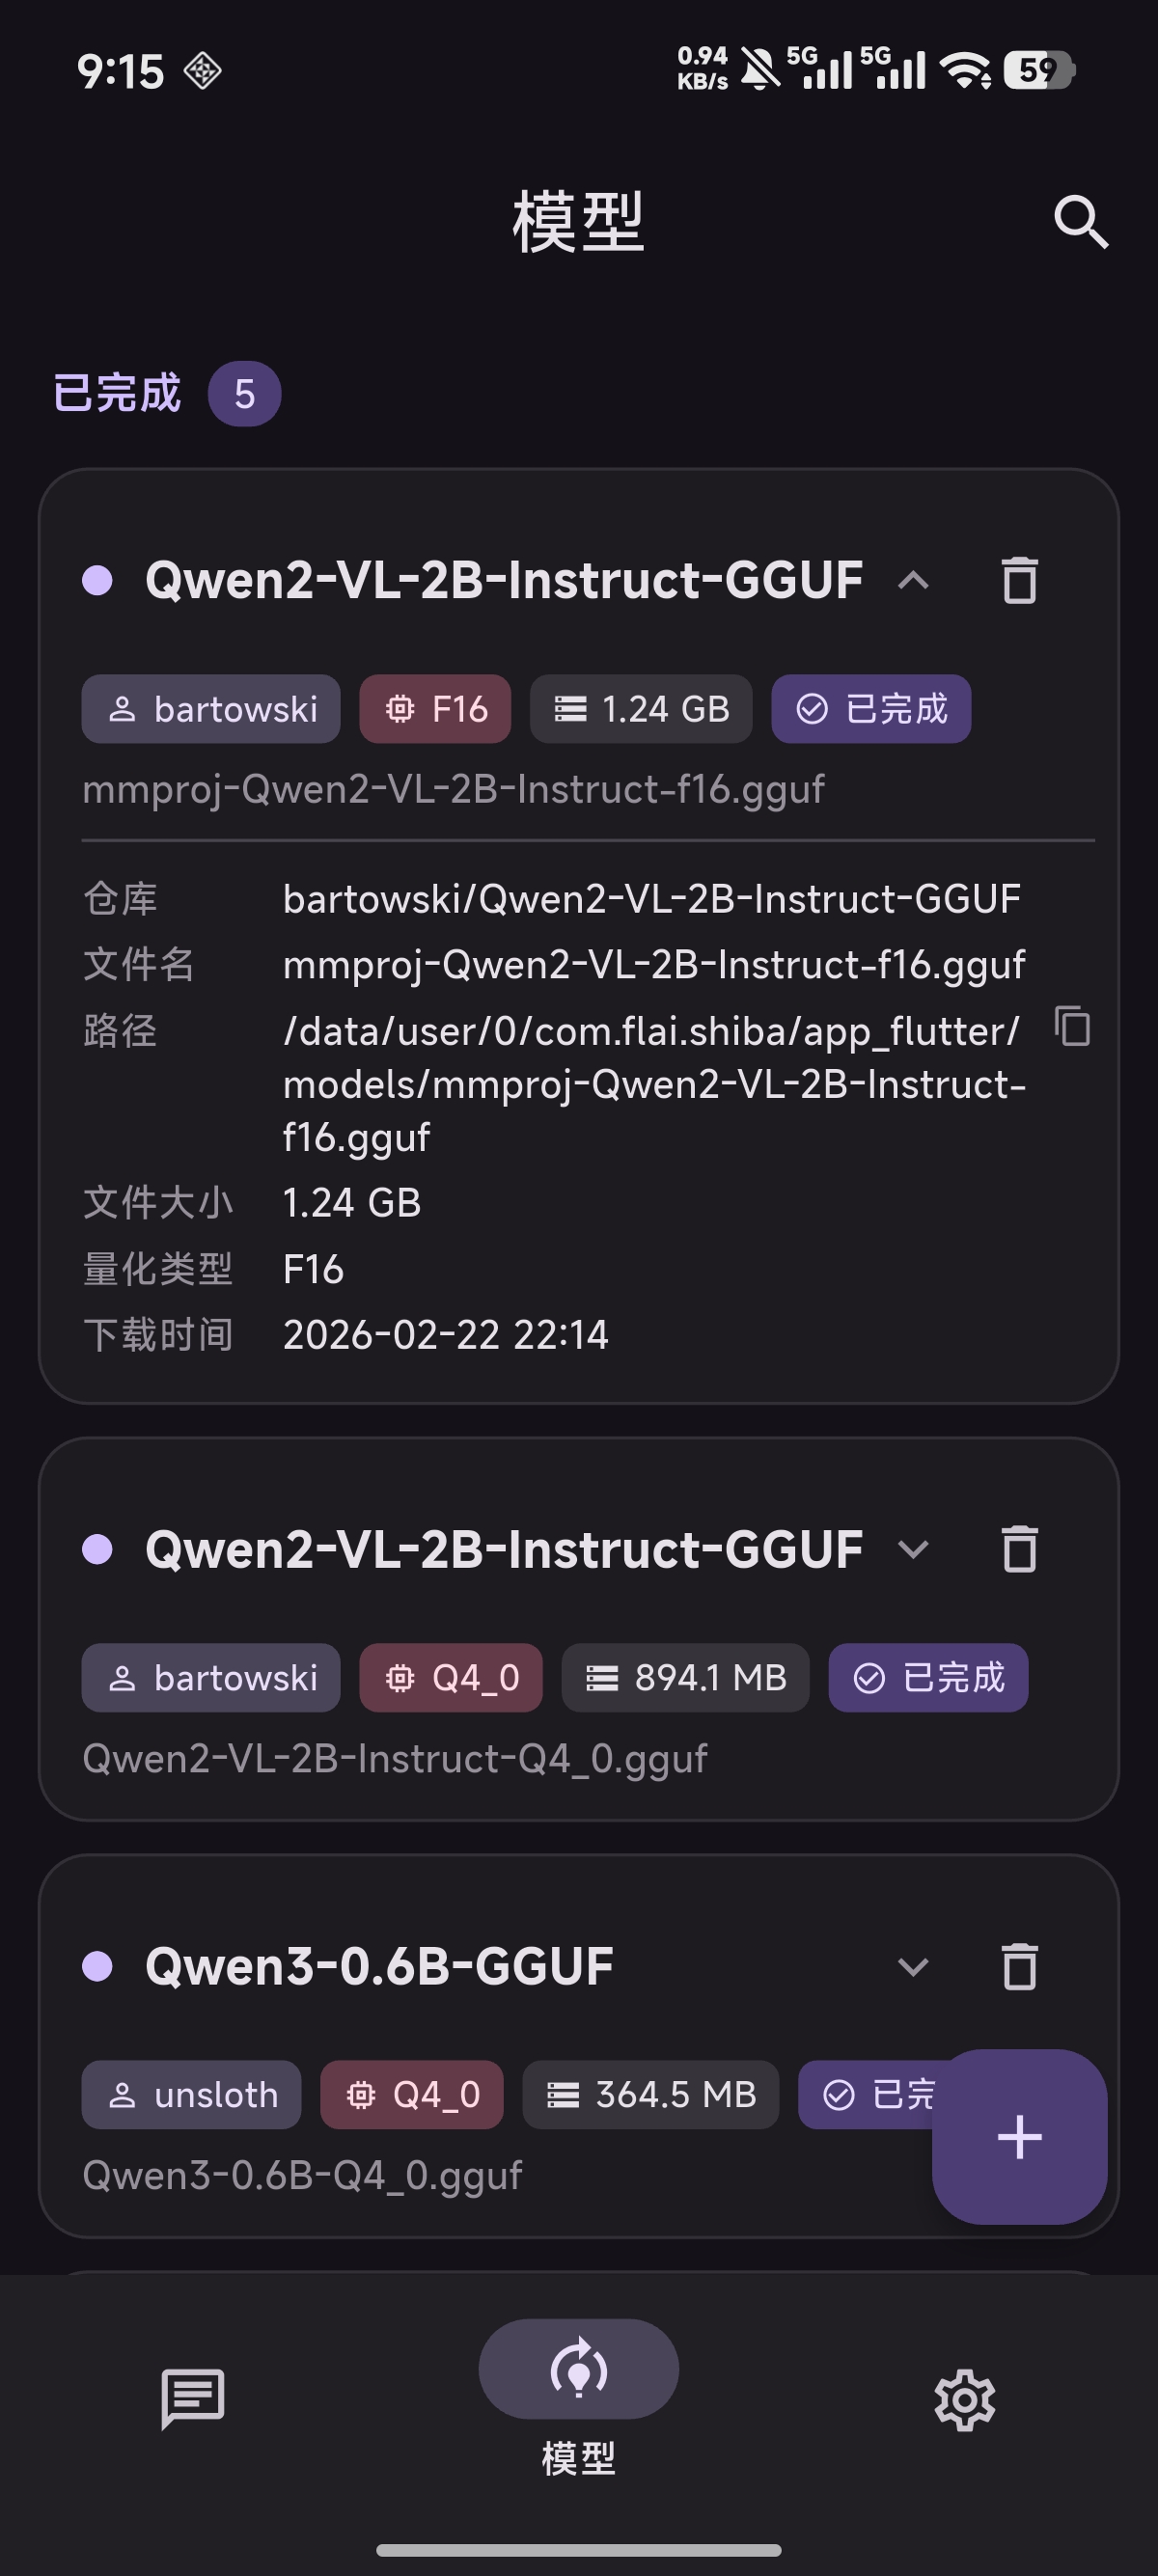
| 📥 Hugging Face 模型中心 | 直接在应用内浏览、搜索、下载 GGUF 模型,国内用户自动使用 hf-mirror.com 镜像 |
| ⏸️ 下载管理 | 支持暂停、续传、取消模型下载,断点续传,实时进度追踪 |
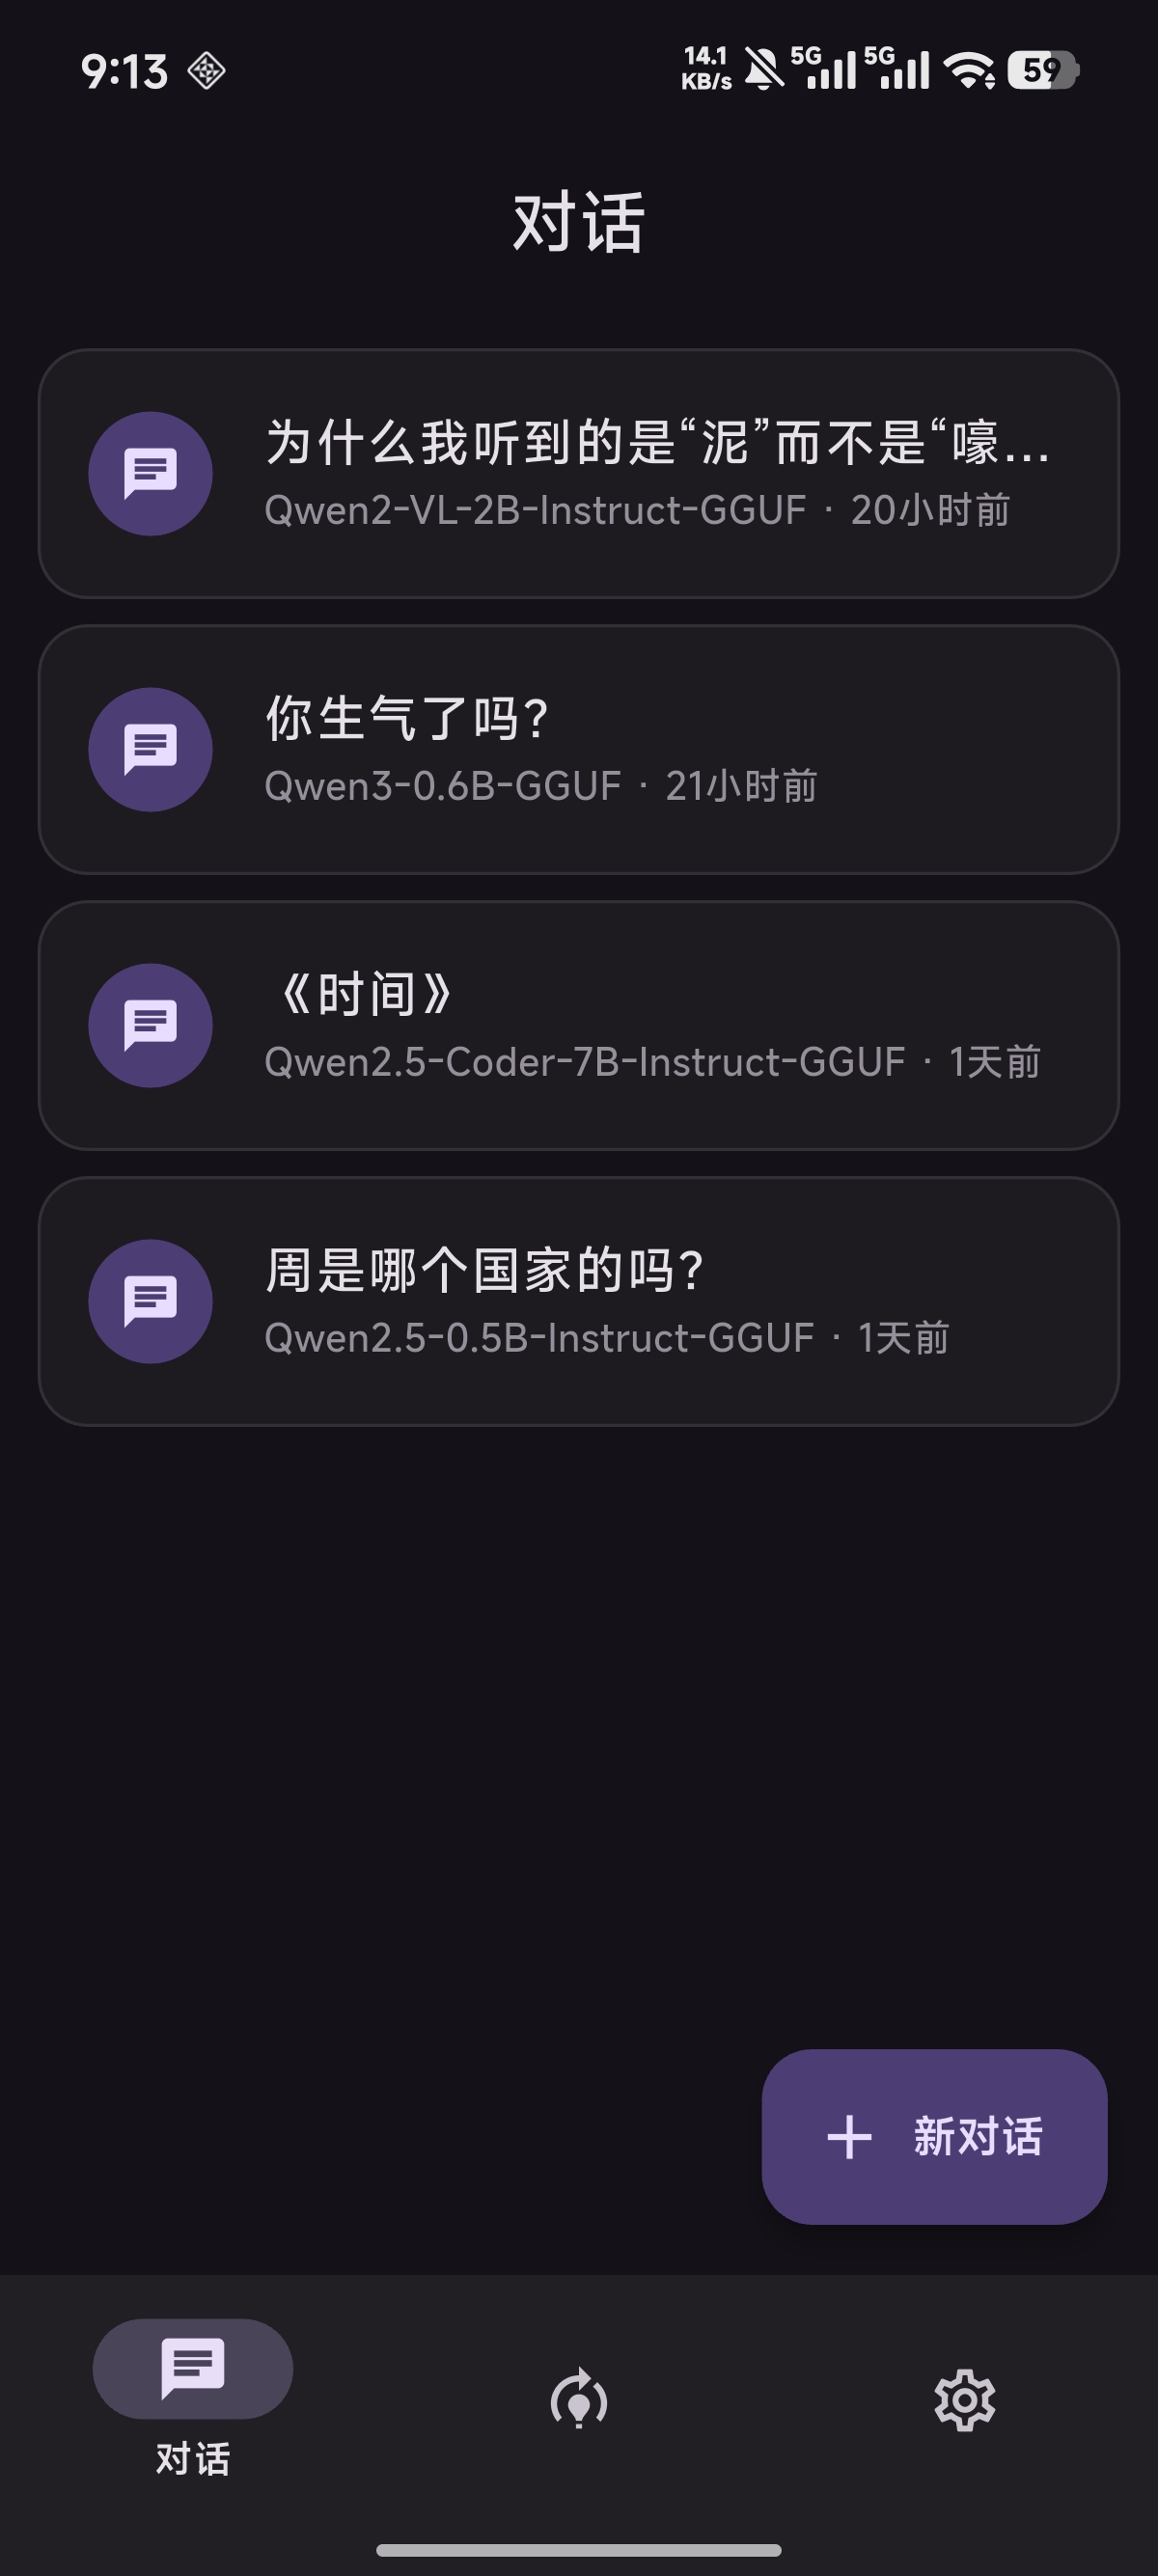
| 💬 多会话管理 | 创建和管理多个聊天会话,完整消息历史持久化存储在 SQLite 中 |
| ✏️ 消息编辑与重发 | 编辑已发送的消息,从该节点重新生成 AI 回复 |
| 🗑️ 批量消息操作 | 长按进入选择模式,多选消息,批量删除 |
| 🖼️ 图片压缩 | 发送图片前可配置压缩参数(分辨率、质量),减少视觉模型处理负担 |
| ⚙️ 会话级参数设置 | 每个会话独立配置系统提示词、Temperature、Top-K、Top-P、最大生成长度、历史轮数 |
| 🌍 多语言界面 | 支持中文、英文、繁體中文、德语、法语 |
| 🎨 Material Design 3 | 简洁现代的 UI,支持亮色/暗色/跟随系统主题切换 |
| 🛡️ 硬件兼容性检测 | 自动检测 CPU 特性(I8MM)、GPU 稳定性(Vulkan DeviceLost),不兼容时优雅降级 |
| 📊 详细诊断信息 | 丰富的错误报告,包含 GGUF 校验、文件完整性哈希、SoC 信息、多阶段加载诊断 |
| 依赖 | 版本 |
|---|---|
| Flutter | ≥ 3.16.0 |
| Dart | ≥ 3.2.0 |
| Android SDK | API 33+(Android 13+) |
| NDK | 27.0.12077973 |
设备需要较新的 SoC,推荐 ARMv8.6-A+(支持 I8MM 指令集),如骁龙 8 Gen 1 及以上。内存越大,可运行的模型越大。
从 Releases 页面下载最新 APK,安装到 Android 设备即可。
-
克隆仓库:
git clone https://github.com/ChinaFLTV/Shiba.git cd Shiba -
安装依赖:
flutter pub get
-
生成代码(Riverpod 生成器、本地化文件):
dart run build_runner build --delete-conflicting-outputs
-
运行应用:
flutter run
-
构建 Release APK(已开启代码压缩和混淆):
flutter build apk --release
Note
Release 构建已开启 ProGuard 代码压缩、资源压缩和混淆。ProGuard 规则已为所有原生插件(llama.cpp、sherpa-onnx、sqflite)预配置。
Shiba 支持所有与 llama.cpp 兼容的 GGUF 格式模型。可以在应用内直接从 Hugging Face 浏览和下载模型(国内用户自动使用 hf-mirror.com 镜像)。
推荐在移动设备上使用的模型:
| 模型 | 参数量 | 所需内存 | 备注 |
|---|---|---|---|
| Qwen 2.5 | 0.5B–3B | 1–4 GB | 速度与质量的良好平衡 |
| Llama 3.2 | 1B–3B | 2–4 GB | Meta 的紧凑模型 |
| DeepSeek-R1-Distill | 1.5B | ~1.1 GB | 推理能力强的蒸馏模型 |
| Phi-3 Mini | 3.8B | ~4 GB | 微软的高效小模型 |
| Gemma 2 | 2B | ~3 GB | Google 的轻量模型 |
Tip
建议从 Q4_K_M 量化版本开始,这是移动端质量与性能的最佳平衡点。在应用内模型中心搜索 "unsloth" 或 "ggml-org" 可以找到预量化模型。
如需图片理解(多模态)功能,请从同一仓库下载主模型和对应的 mmproj 文件。Shiba 会自动检测并加载视觉投影器。
lib/
├── core/              # 常量、工具类、主题、CPU/GPU 硬件检测
├── data/
│   ├── database/      # SQLite 数据库(sqflite)
│   ├── models/        # 数据模型(会话、消息、本地模型、HF 模型)
│   ├── repositories/  # 数据访问层
│   └── services/      # LLM 推理、TTS、STT、下载、Hugging Face API
├── l10n/              # 国际化(ARB 文件 + 生成的 Dart 代码)
├── providers/         # Riverpod 状态管理
├── ui/
│   ├── chat/          # 聊天界面、消息气泡、输入栏
│   ├── home/          # 首页
│   ├── models/        # 模型管理、搜索、下载界面
│   ├── settings/      # 应用设置(主题、语言、TTS/STT、推理参数)
│   └── shared/        # 可复用对话框(TTS/STT 下载进度)
├── app.dart           # 应用根组件
└── main.dart          # 入口文件
- 状态管理:Riverpod(带代码生成)
- 本地存储:SQLite(sqflite)
- LLM 推理:llamadart(llama.cpp 的 Dart 绑定)
- 语音:sherpa-onnx,TTS 使用 MeloTTS,STT 使用 SenseVoice
Shiba 开箱即用支持 5 种语言:
| 语言 | 代码 |
|---|---|
| English | en |
| 简体中文 | zh |
| 繁體中文 | zh_Hant |
| Deutsch | de |
| Français | fr |
添加新语言:在 lib/l10n/ 下创建 app_<语言代码>.arb 文件,然后运行 flutter gen-l10n。
我们欢迎各种形式的贡献——Bug 修复、新功能、翻译、文档改进,每一份贡献都很重要。
- Fork 本仓库
- 创建特性分支 (
git checkout -b feature/amazing-feature) - 提交更改 (
git commit -m 'feat: 添加某个功能') - 推送到分支 (
git push origin feature/amazing-feature) - 发起 Pull Request
提交前请确保代码风格一致,并通过 flutter analyze 检查。
Q:Shiba 和 Ollama 是什么关系? A:Ollama 是桌面端运行大模型的首选工具。Shiba 把同样的理念带到了移动端——简单、本地、私密。两者没有代码关联,但精神一脉相承。
Q:支持哪些设备? A:Android 13+(API 33+)且 CPU 支持 ARMv8.6-A+(I8MM)的设备。推荐骁龙 8 Gen 1 及以上。iOS 支持在计划中。
Q:模型需要多少存储空间? A:因模型而异。量化后的 1–3B 模型通常在 0.5 GB 到 2.5 GB 之间。TTS 模型约 170 MB,STT 模型约 230 MB。
Q:可以使用自己的 GGUF 模型吗? A:可以。通过应用内模型中心从 Hugging Face 下载任何 GGUF 模型即可。
Q:支持 GPU 加速吗? A:支持。Shiba 会自动检测最佳后端(Vulkan/Metal/CPU),如果 GPU 推理不稳定会自动回退到 CPU。
Q:为什么推理速度很慢? A:推理速度取决于 SoC、内存和模型大小。尝试使用更小或量化程度更高的模型(如 Q4_K_S 或 IQ4_XS)。
Q:国内可以下载模型吗? A:可以。Shiba 默认使用 hf-mirror.com 作为 Hugging Face 镜像,TTS/STT 模型下载也支持镜像回退。
本项目基于 MIT 许可证 发布。
Shiba 基于以下优秀的开源项目构建:
- llama.cpp — 大模型推理引擎
- llamadart — llama.cpp 的 Dart 绑定
- sherpa-onnx — 端侧语音处理(TTS & STT)
- Flutter — UI 框架
- Riverpod — 状态管理
- Hugging Face — 模型中心
用 ❤️ 为端侧 AI 而作